💡 核心結論速覽 (TL;DR)
- 跟 Opus 5.5 差多少:Sonnet 5.5 跟 Sonnet 5 同價、輸出快 30% 以上,單價 2 美元/10 美元剛好是 Opus 5.5 的一半;知識工作測驗只落後 2 分,終端機程式任務還以 70.6% 對 66.4% 反超。
- 最容易算錯:單價一半不等於每題一半。兩款都把思考檔位(effort)開到最高時,Sonnet 5.5 每題 7.60 美元,比 Opus 5.5 的 5.98 美元貴 27%。
- 免費與月費:免費版就能用;Claude Code 撞到 Opus 上限可切 Sonnet 5.5 繼續做;資安類請求會被換成 Sonnet 5,要自己切回。
- 怎麼選:我拿同一題修 bug 實測,兩款 3 個 bug 都抓到、修法一模一樣;範圍清楚的工作給 Sonnet 5.5,effort 停在 medium 或 high,模糊、長時間、做錯很貴的留給 Opus 5.5。
Sonnet 5.5 值得用嗎?值得,但千萬別把「單價只要一半」當成「帳單只要一半」。
Claude Sonnet 5.5 是 Anthropic 在 2026 年 9 月 28 日推出的新模型,API 價格維持每百萬 token(AI 計費的字詞單位)輸入 2 美元、輸出 10 美元,剛好是 Opus 5.5 的一半。
例外出在 effort 開到最高的時候,Sonnet 5.5 每題反而比 Opus 5.5 貴 27%:這是第三方評測機構 Artificial Analysis 把兩款都拉到 max、跑同一套評測得出的結果。
effort 是思考檔位,由低到高分 low、medium、high、xhigh、max 五檔,開越高想越久、token 也用越多。多出來的錢主要花在重讀快取:長任務裡它讀快取的量是 Opus 5.5 的 1.68 倍,而快取讀取兩款同價。
我每天用 AI 超過 10 小時,付的是 Claude Max 20x 每月 200 美元的方案,每次新模型上線,第一件事就是打開價目表重算。
我拿這 200 美元照 API 輸出價換算:Sonnet 5.5 是 2,000 萬個輸出 token,Opus 5.5 是 1,000 萬(訂閱額度不是這樣算,這裡只看比例)。
光看這個比例,很容易就想全面換過去。但我想先幫你分清楚:你是付 API 的、付月費的,還是在 Claude Code 裡寫程式的?三種人該盯的格子不一樣,下面分開算;我也拿同一題修 bug 實測了兩款,結果放在比較表後面。
Sonnet 5.5 是什麼?一句話:接近 Opus 5.5 的日常能力,一半的單價
Claude Sonnet 5.5 是 Claude 5.5 家族的第二款模型,定位是 Opus 5.5 旁邊那個更快、更便宜的搭檔:Anthropic 說它最擅長範圍講得清楚的日常任務、修 bug,以及做文件、簡報和試算表。
規格跟 Opus 5.5 幾乎同一個級距:1M token 上下文、單次最多輸出 128K、知識截止在 2026 年 6 月。差別在思考方式,Opus 5.5 的思考關不掉,Sonnet 5.5 可以把開頭那段思考關掉,它在 API 的預設 effort 是 high。
上線的地方很廣:Claude 網頁與 App、Claude Code、Claude API,以及 Amazon Bedrock、Google Cloud、Microsoft Foundry。
GitHub Copilot 也在同一天開放給 Pro、Pro+、Max、Business、Enterprise 方案,逐步推送中。還在猶豫 Copilot 跟 Cursor 哪個適合你,可以看我整理的Cursor 與 GitHub Copilot 差在哪、各適合誰。
我看新模型習慣先問一個很 PM 的問題:它想取代誰?Sonnet 5.5 的答案很清楚,它要接走的是「其實用不到 Opus 的那些工作」,Opus 5.5 還是留在原位。
Anthropic 自家的模型總覽也寫:不確定用哪一款,就先從 Opus 5.5 開始。我的理解是,Sonnet 5.5 是給「已經知道自己要什麼」的人用的。任務講得清楚,它就是划算的那一款;講不清楚,便宜的單價很容易被來回修正吃掉。
想先看整個家族(Fable、Opus、Sonnet、Haiku)各自該接什麼工作,可以翻我整理的Claude 四款模型分工對照,再回來看這篇的帳。
Sonnet 5.5 價格:單價沒變,「便宜 30%」是跟 Sonnet 5 比
Sonnet 5.5 的 API 價格是每百萬 token 輸入 2 美元、輸出 10 美元,跟 Sonnet 5 一模一樣;Anthropic 說的「最多便宜 30%」指的是同一份工作的總花費,比較對象是 Sonnet 5,不是 Opus 5.5。
公告的說法很精準:在他們的測試裡,每個任務的成本比前一代最多低 30%。而且斷詞器跟 Sonnet 5 相同,同一段文字算出來的 token 數一樣,所以省下來的部分只可能來自一件事:它做同一件事用掉的 token 變少了。
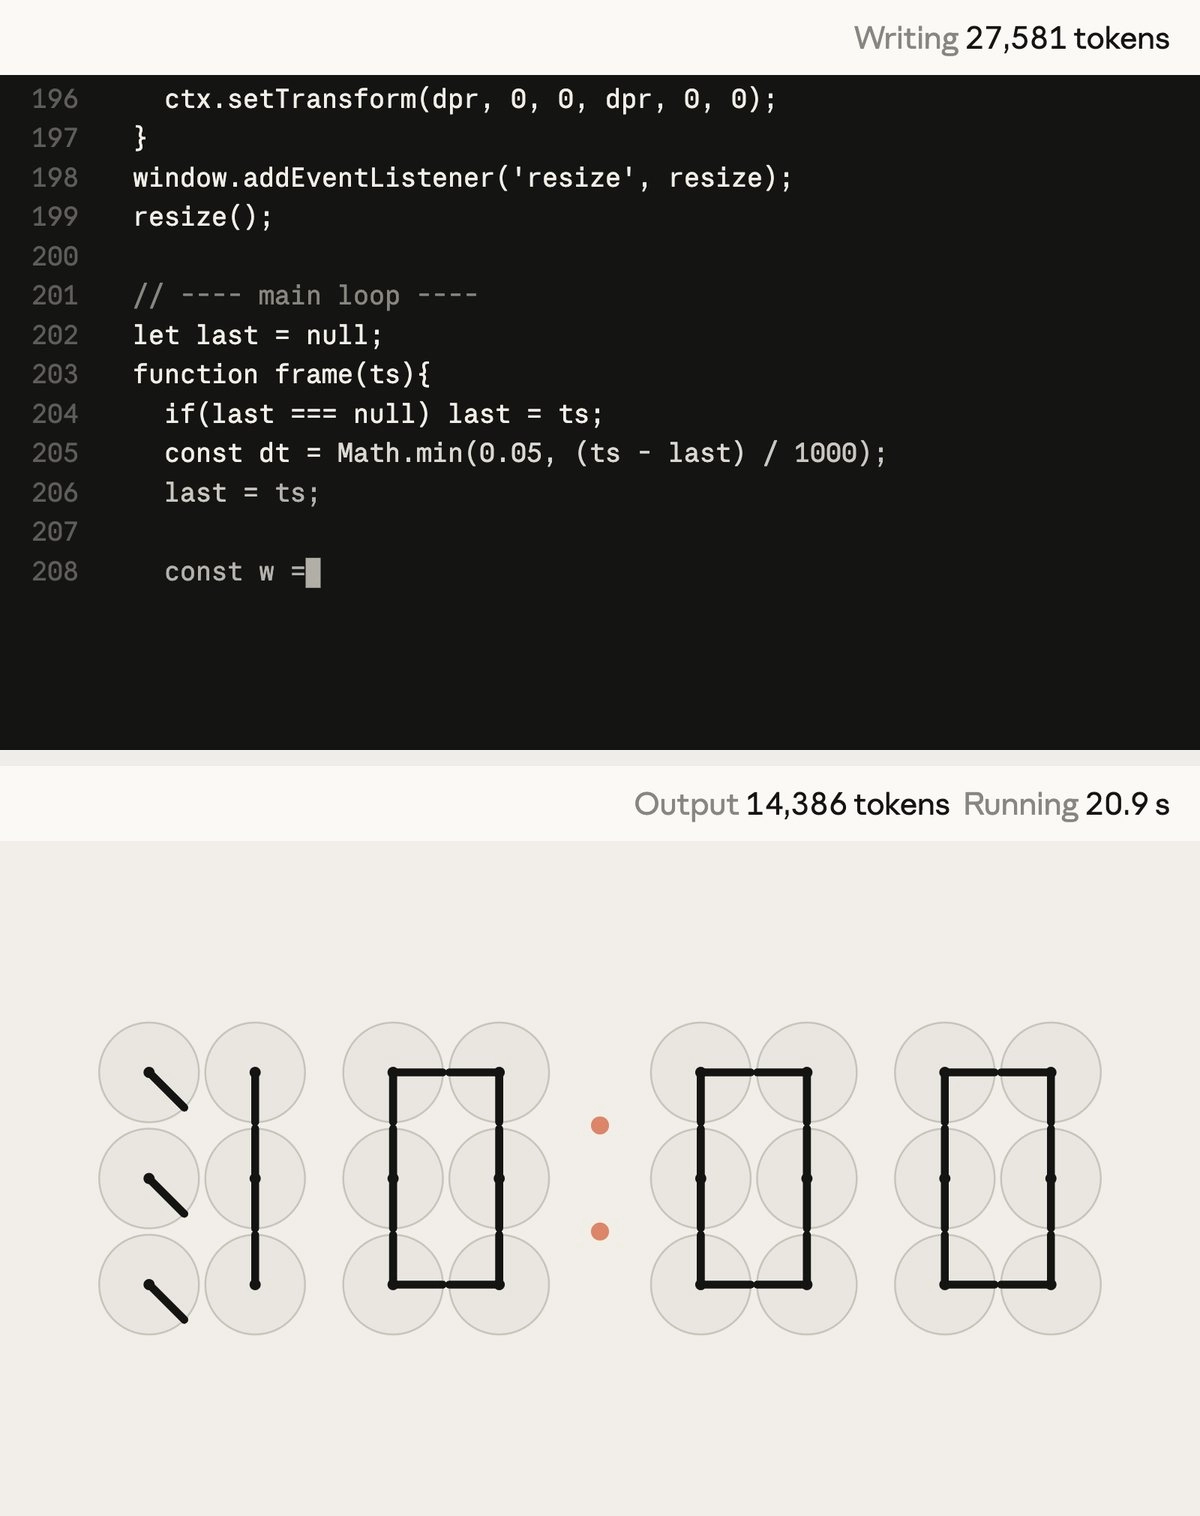
發布頁放了一組很直觀的示範:同一個「用時鐘拼成的時鐘」程式,前一代模型寫到 27,581 個 token 還沒寫完,Sonnet 5.5 用 14,386 個 token 就寫完、跑起來了。這只是單一範例,但方向跟「最多省 30%」是一致的。
換成帳單來看:同一份工作在 Sonnet 5 花 1 美元,換到 Sonnet 5.5 最好的情況是 0.7 美元。「最多」是上限,換個任務可能省更少,甚至沒省到。
其他折扣照舊:prompt caching(重複送的同一段內容改算便宜的快取價)最多省 90%,Batch 批次處理打五折。有個小改變對寫應用的人很實用:可快取的最小提示從 Sonnet 5 的 1,024 個 token 降到 512 個,比較短的系統提示現在也吃得到快取價。
至於「輸出快 30% 以上」,老實說我對這類數字一向保留,我不太相信「用了就省下幾小時」的說法。快 30% 省的是等它吐字的時間,工作量不會跟著變少。
斷詞器換代那筆帳,我在〈為什麼漲價取消了、Opus 帳單反而多三成〉那篇拆過;這次 Sonnet 5.5 沒換斷詞器,可以直接拿 token 數比。
付 API 的人,換模型前先把帳單裡 Sonnet 5 那幾行的 token 數記下來,換過去之後同一批任務再對一次,才知道那 30% 你拿到多少。
Sonnet 5.5 vs Opus 5.5 差在哪?價格、跑分、速度一張表
Sonnet 5.5 和 Opus 5.5 最大的差別在價格:Opus 的單價是 Sonnet 的兩倍,能力卻只差一點。
知識工作測驗 GDPval-AA 只差 2 分(1844 對 1846),終端機程式任務 Terminal-Bench 4.0 反而是 Sonnet 5.5 贏(70.6% 對 66.4%)。
| 項目 | Sonnet 5.5 | Opus 5.5 | Sonnet 5 |
|---|---|---|---|
| API 價格(輸入/輸出) | 2/10 美元 | 4/20 美元 | 2/10 美元 |
| 快取讀取 | 0.20 美元 | 0.20 美元 | 0.20 美元 |
| API 預設 effort | high | medium | high |
| Claude Code 預設 effort | medium | medium | high |
| Terminal-Bench 4.0 | 70.6% | 66.4% | 10.3% |
| CursorBench 4.0 | 55.5% | 57.8% | 34.1% |
| GDPval-AA v2.1 | 1844 | 1846 | 1449 |
| OSWorld 2.1 | 80.1% | 81.8% | 57.0% |
| 輸出速度(max effort) | 每秒 138.7 token | 每秒 92.8 token | — |
價格以每百萬 token 計;跑分取自 Anthropic 發布頁(CursorBench 測寫程式、OSWorld 測操作電腦),輸出速度取自 Artificial Analysis。
表裡有兩個細節要一起看。第一,Terminal-Bench 那格,Opus 5.5 放的是它各檔位裡分數最高的 xhigh 成績,Sonnet 5.5 照樣贏。
第二,Sonnet 5 在同一套測驗只有 10.3%,這種跳幅我不會拿來說它強了 7 倍;單一測驗落差這麼大時,我寧可看幾項一起的方向。
方向其實很一致:Sonnet 5.5 輸掉的幾格(CursorBench、OSWorld)都只差 2 分上下,贏的那格剛好是 Claude Code 這類終端機代理最常做的事。
Anthropic 在公告裡也寫得很直白,複雜、開放式、需要長時間判斷的工作,Opus 5.5 仍然明顯比較強。
我看跑分的習慣是先找「差距落在哪一類題目」,總分擺後面。這張表我讀出來的結論是:可以驗收的工作(測試會過、畫面會動)比較適合先交給 Sonnet 5.5;需要它自己拿主意、沒有標準答案的工作,那一點點分差就會被放大。
如果你想知道 Opus 5.5 那邊為什麼價格只降 20%、預設 effort 又被調到 medium,我在Opus 5.5 評價那篇把「省 40%」拆開算過。
Sonnet 5.5 vs Opus 5.5 實測:同一段帳單程式,3 個 bug 都抓到,差在多檢查一步
Sonnet 5.5 和 Opus 5.5 修同一段藏了 3 個 bug 的帳單程式,兩款都把 3 個 bug 全部抓到,修好的函式一字不差;差別在 Opus 5.5 多做了一步檢查,看得到的回答也長了將近六成。
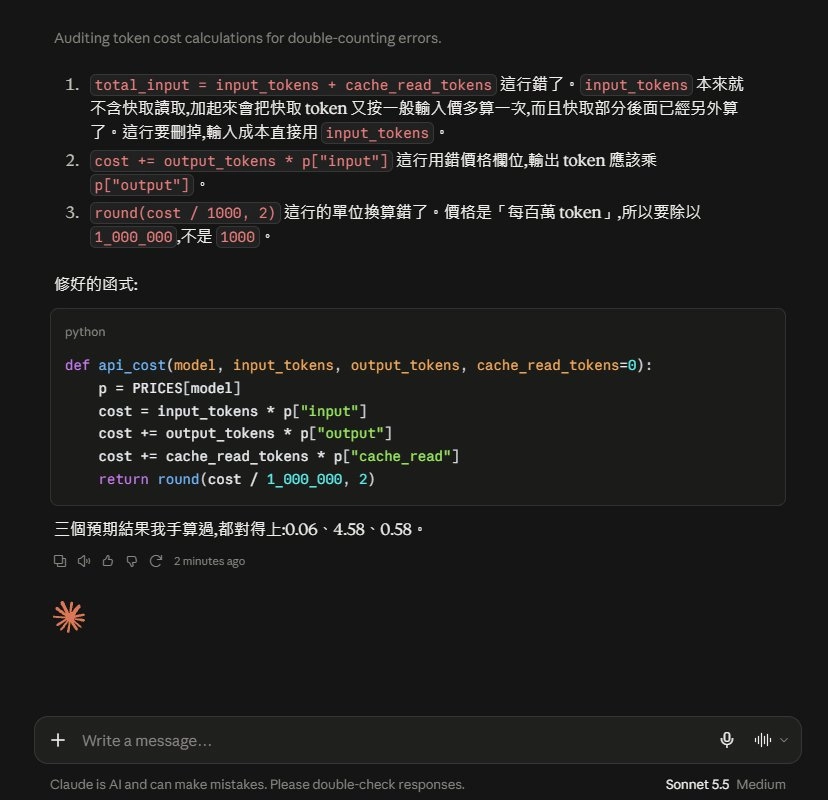
題目是一個算 Claude API 帳單的 Python 小函式,我在裡面埋了 3 個錯:快取 token 被重複算進一般輸入、輸出用錯單價、單位除成了每千 token。
我把同一段提示詞分別丟給兩款、各跑一次,兩邊都開新對話,effort 都是 Medium。
我把兩份修好的函式貼進 Python 跑了 3 個測試,結果都是 0.06、4.58、0.58 美元,3 題全過;原本的版本算出來是 44、4,980、2,220 美元,錯得離譜。
差別在回答方式。Sonnet 5.5 列完 3 個 bug、給出修好的函式,最後只補一句「三個預期結果我手算過,都對得上」。
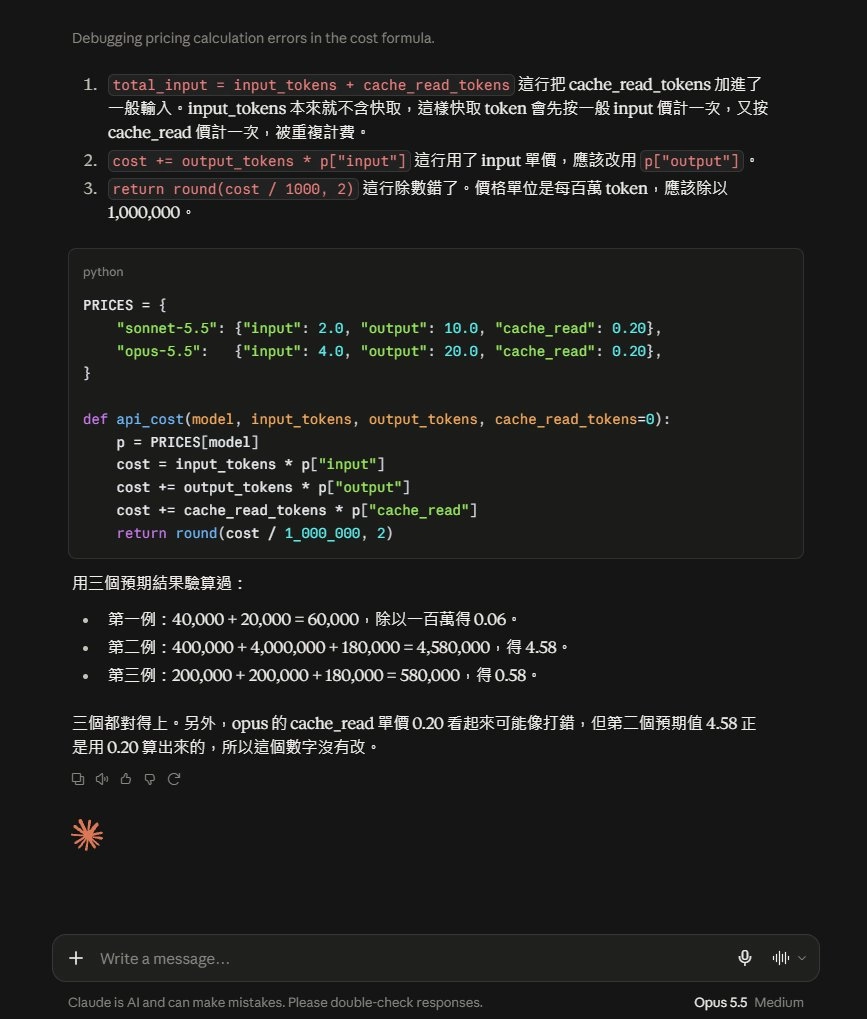
Opus 5.5 則把三題的算式一條條寫出來,還多提醒一句:Opus 的快取讀取價 0.20 看起來像打錯,但用預期值 4.58 反推是對的,所以沒改。這一步不在題目要求裡,我會把它算成 Opus 5.5 比較愛「自己多想一層」的例子。
看得到的回答長度,Sonnet 5.5 約 510 個字元、Opus 5.5 約 800 個(Opus 多貼了一次價目表),長了將近六成。思考過程看不到,這不能直接換算成 token 帳單,只能說範圍講清楚的工作,Sonnet 5.5 回得比較乾脆。
我原本最想看的,是提示詞指南提到的那個習慣:Sonnet 5.5 寫程式時會主動補測試和文件。這題我在提示詞裡明講「不要加說明文件或額外測試」,兩款都照做,一行都沒多加;至少在 Medium、這一題的條件下,明講就有用。
這一題兩款我都給過關。如果是自己付 API 的錢,這種範圍清楚、有驗收條件的修 bug,我會交給 Sonnet 5.5;Opus 5.5 多想的那一步,我寧可留給沒有標準答案的題目。
題目原文放在下面,你可以貼進自己的 Claude 重跑一次:
下面這個 Python 函式用來算 Claude API 帳單,但測試跑不過。請找出所有 bug 並修正。

規則:
- 價格單位是「每百萬 token 的美元」
- input_tokens 是沒進快取的新輸入,不包含 cache_read_tokens
- 只修 bug:不要改函式名稱和參數、不要加新功能、不要重構、不要加說明文件或額外測試
- 不用執行程式,直接回答

PRICES = {
    "sonnet-5.5": {"input": 2.0, "output": 10.0, "cache_read": 0.20},
    "opus-5.5":   {"input": 4.0, "output": 20.0, "cache_read": 0.20},
}

def api_cost(model, input_tokens, output_tokens, cache_read_tokens=0):
    p = PRICES[model]
    total_input = input_tokens + cache_read_tokens
    cost = total_input * p["input"]
    cost += output_tokens * p["input"]
    cost += cache_read_tokens * p["cache_read"]
    return round(cost / 1000, 2)

預期結果:
api_cost("sonnet-5.5", 20000, 2000) → 0.06
api_cost("opus-5.5", 100000, 200000, cache_read_tokens=900000) → 4.58
api_cost("sonnet-5.5", 100000, 20000, cache_read_tokens=900000) → 0.58

回答格式:
1. 每個 bug 一行:哪一行、錯在哪
2. 修好的完整函式
單價一半,為什麼 Sonnet 5.5 每題可能比 Opus 5.5 貴?
Sonnet 5.5 每題可能比 Opus 5.5 貴,問題出在快取:開到 max 跑長時間的代理任務時,Sonnet 5.5 重讀快取的量多很多,而快取讀取兩款都是每百萬 token 0.20 美元,單價優勢在這一塊用不上。
Artificial Analysis 兩款都用 max effort 跑同一套 10 項評測:Sonnet 5.5 輸出了 4.1 億個 token、每題平均 7.60 美元;Opus 5.5 只輸出 2.6 億個、每題 5.98 美元。
這組數字很反直覺,我把輸出那一塊單獨拿出來算下來:4.1 億乘以每百萬 10 美元約 4,100 美元,2.6 億乘以每百萬 20 美元約 5,200 美元。光看輸出這塊的花費,Sonnet 5.5 還少 21%。
那 27% 貴在哪?Artificial Analysis 其實有公布拆帳。Sonnet 5.5 每題 7.60 美元裡,快取讀取就佔 4.41 美元,Opus 5.5 只有 2.42 美元;輸出那塊反而是 Sonnet 便宜(1.93 對 2.38 美元)。
我把兩邊的拆帳攤開算:每題多出的 1.62 美元裡,快取讀取多了 1.99 美元,輸出還少了 0.45 美元。換算成量,整套評測 Sonnet 5.5 讀了約 180 億個快取 token,Opus 5.5 約 107 億,是 1.68 倍。
10 項評測裡有 7 項 Sonnet 5.5 比較便宜,貴的主要是 AA-Briefcase 和 Terminal-Bench 這兩項長時間的代理任務;整套跑完的總花費,Sonnet 5.5 也只比 Opus 5.5 多 3%。
Anthropic 在公告裡也講得很老實:Sonnet 5.5 在低 effort 時最能跟 Opus 5.5 互補、每題比較便宜;開到高 effort,表現可以接近,花費也差不多。
提示詞指南寫到的行為正好對得上:effort 開到 xhigh 或 max 時,Sonnet 5.5 做完還會自己開審查回合,環境允許時甚至派子代理去複查,每多一輪就多讀一次快取。他們在寫程式的任務上測試,加一段「做完就停」的系統提示後,max 下的整段成本少了大約三分之一,品質沒有變。
所以指南建議,xhigh 和 max 只留給量過、確定品質真的有提升的工作。我會照這個原則走:Sonnet 5.5 先停在 medium 或 high,想往上開之前,先拿同一個任務前後比一次。
真的要開到 max,這段是我照指南意思改寫的中文版,可以直接貼進系統提示:
事情做完、檢查通過就停下來回報。除非我要求審查,否則不要自己再開一輪審查或加固,也不要派審查用的子代理;覺得值得更深入檢查,就在最後說一聲。
還有一個容易被忽略的差異:API 的預設 effort,Sonnet 5.5 是 high、Opus 5.5 是 medium。只換 model ID 就拿帳單比,等於拿 high 去比 medium,比到的是檔位差距,所以 API 請求最好把 effort 明確寫出來。
速度這邊,Sonnet 5.5 每秒輸出 138.7 個 token,Opus 5.5 是 92.8 個,速度約是 1.5 倍。
不過開到 max 時兩款都要先想很久:Sonnet 5.5 通常要等 6 分多鐘才吐出第一個字,Opus 5.5 要 11 分多鐘。快是真的快,但聊天時沒有人等得了 6 分鐘。
effort 五檔各自會想多久、怎麼設,我在Claude effort 5 檔差在哪那篇列成表,Sonnet 5.5 一樣適用。
快取讀取同樣 0.20 美元:長任務換 Sonnet 5.5 能省多少?我算三種情境
Sonnet 5.5 和 Opus 5.5 的快取讀取都是每百萬 token 0.20 美元,所以越依賴快取、輸出越少的工作,Sonnet 省得就越少;我套了三種使用情境,Sonnet 的花費落在 Opus 的 50% 到 59%。
兩個 0.20 美元是這樣來的:Opus 5.5 的快取讀取是基礎輸入價 4 美元的 5%,Sonnet 5.5 是 2 美元的 10%。比例看起來 Sonnet 貴一倍,絕對價其實一樣,跟我之前算的〈Fable 5.1 快取比例降了、有人卻只省 0.6%〉是同一種陷阱。
| 使用情境 | Opus 5.5 | Sonnet 5.5 | Sonnet 佔比 |
|---|---|---|---|
| 聊天:2 萬輸入+2 千輸出,不用快取 | 0.12 美元 | 0.06 美元 | 50% |
| 長任務:90 萬快取讀取+10 萬新輸入+20 萬輸出 | 4.58 美元 | 2.38 美元 | 52% |
| 讀大專案問問題:90 萬快取讀取+10 萬新輸入+2 萬輸出 | 0.98 美元 | 0.58 美元 | 59% |
我拿這三種情境套兩款價目表算下來,聊天那種短對話最接近「剛好一半」,重度快取、輸出又少的第三列差最少。長任務那一列沿用我在 Opus 5.5 那篇用過的例子,兩篇可以對照著看。
我反過來算損益兩平更有用:長任務那一列,Sonnet 5.5 的輸出 token 要超過 Opus 5.5 的 2.1 倍才會比較貴;讀大專案問問題那一列,要到 3 倍。
Artificial Analysis 那組評測的輸出是 1.58 倍,其實沒超線;讓它變貴的是快取讀取多了 1.68 倍,也就是下面說的「吃進去的 token 不一樣多」。
這三列都沒算快取寫入,也假設兩款吃進去的 token 一樣多。實際跑的時候,Sonnet 5.5 如果來回多問你幾次,每一輪都會多讀一次快取,所以它省不省,最後還是看你把任務講得多清楚。
想知道自己屬於哪一列,可以把 API 回應裡 usage 欄位的 cache_read_input_tokens 加總,看快取讀取佔輸入多少比例;比例越高,換 Sonnet 5.5 省得越少。
免費版能用 Sonnet 5.5 嗎?Pro、Max 付月費的人要看額度
免費版 Claude 就能用 Sonnet 5.5:Anthropic 寫明任何人都能在 Claude.ai 網頁、iOS 和 Android 上用它聊天;Opus 要 Pro 以上,Claude Code 也是 Pro 起跳。
App 裡的預設 effort 是 medium,跟 API 的 high 不一樣。Claude 的支援地區也要先確認:有台灣,但不含香港、澳門和中國大陸。
付費方案的價格沒有動:Pro 年繳每月 17 美元(一次付 200 美元)、月繳 20 美元;Max 從每月 100 美元起,可選 Pro 的 5 倍或 20 倍用量。方案之間怎麼挑,我在〈多付 80 美元升 Max、上下文卻沒變大〉那篇算過。
用台灣的信用卡付美元訂閱,海外手續費和回饋差多少,我在ChatGPT、Claude、Gemini 刷卡回饋實算那篇也對過。
付月費的人真正該在意的是額度。Anthropic 從不公布五小時或每週的絕對數字,只給倍數。
企業版的用量指南倒是把各模型的 token 消耗強度分成四級:Fable 非常高、Opus 高、Sonnet 中等、Haiku 低。照這個分級,我的解讀是 Sonnet 5.5 通常比較省額度;但從前面那組 max effort 的數字看,開到頂時不一定。
還有一個很實用的機制:Claude Code 除了全模型共用的 session 與每週上限,還有模型家族專屬的上限。
看到「You've hit your Opus limit」時,用 /model 切到 Sonnet 5.5 就能繼續做;全模型共用的那兩道上限,換模型也救不回來。
切換也有代價:每個模型有自己的 prompt cache,切過去的第一個請求會把整段對話重讀一遍,沒有任何快取命中。對話越長這一下越貴,所以我會建議在告一段落的地方切,不要在一段超長對話的正中間切。
我自己是付到最高階那種人,不是因為錢多,是受不了寫到一半跳出額度用完,那個中斷的成本比價差高。付 Max 的人(我自己付的是 Max 20x、每月 200 美元)撞到 Opus 家族上限時,先切 Sonnet 5.5 把手上的事收尾,通常比乾等重置划算。
週額度為什麼會一天就見底,我在〈Max 20x 一天燒光週額度〉那篇把算式列過。
還在想 Pro、Max 的月費值不值得付,或 Claude 之外要不要再訂一家,我另外整理過哪些付費 AI 值得續訂、哪些免費版就夠。
Claude 為什麼自己換成 Sonnet 5?自動換模型的觸發條件和關法
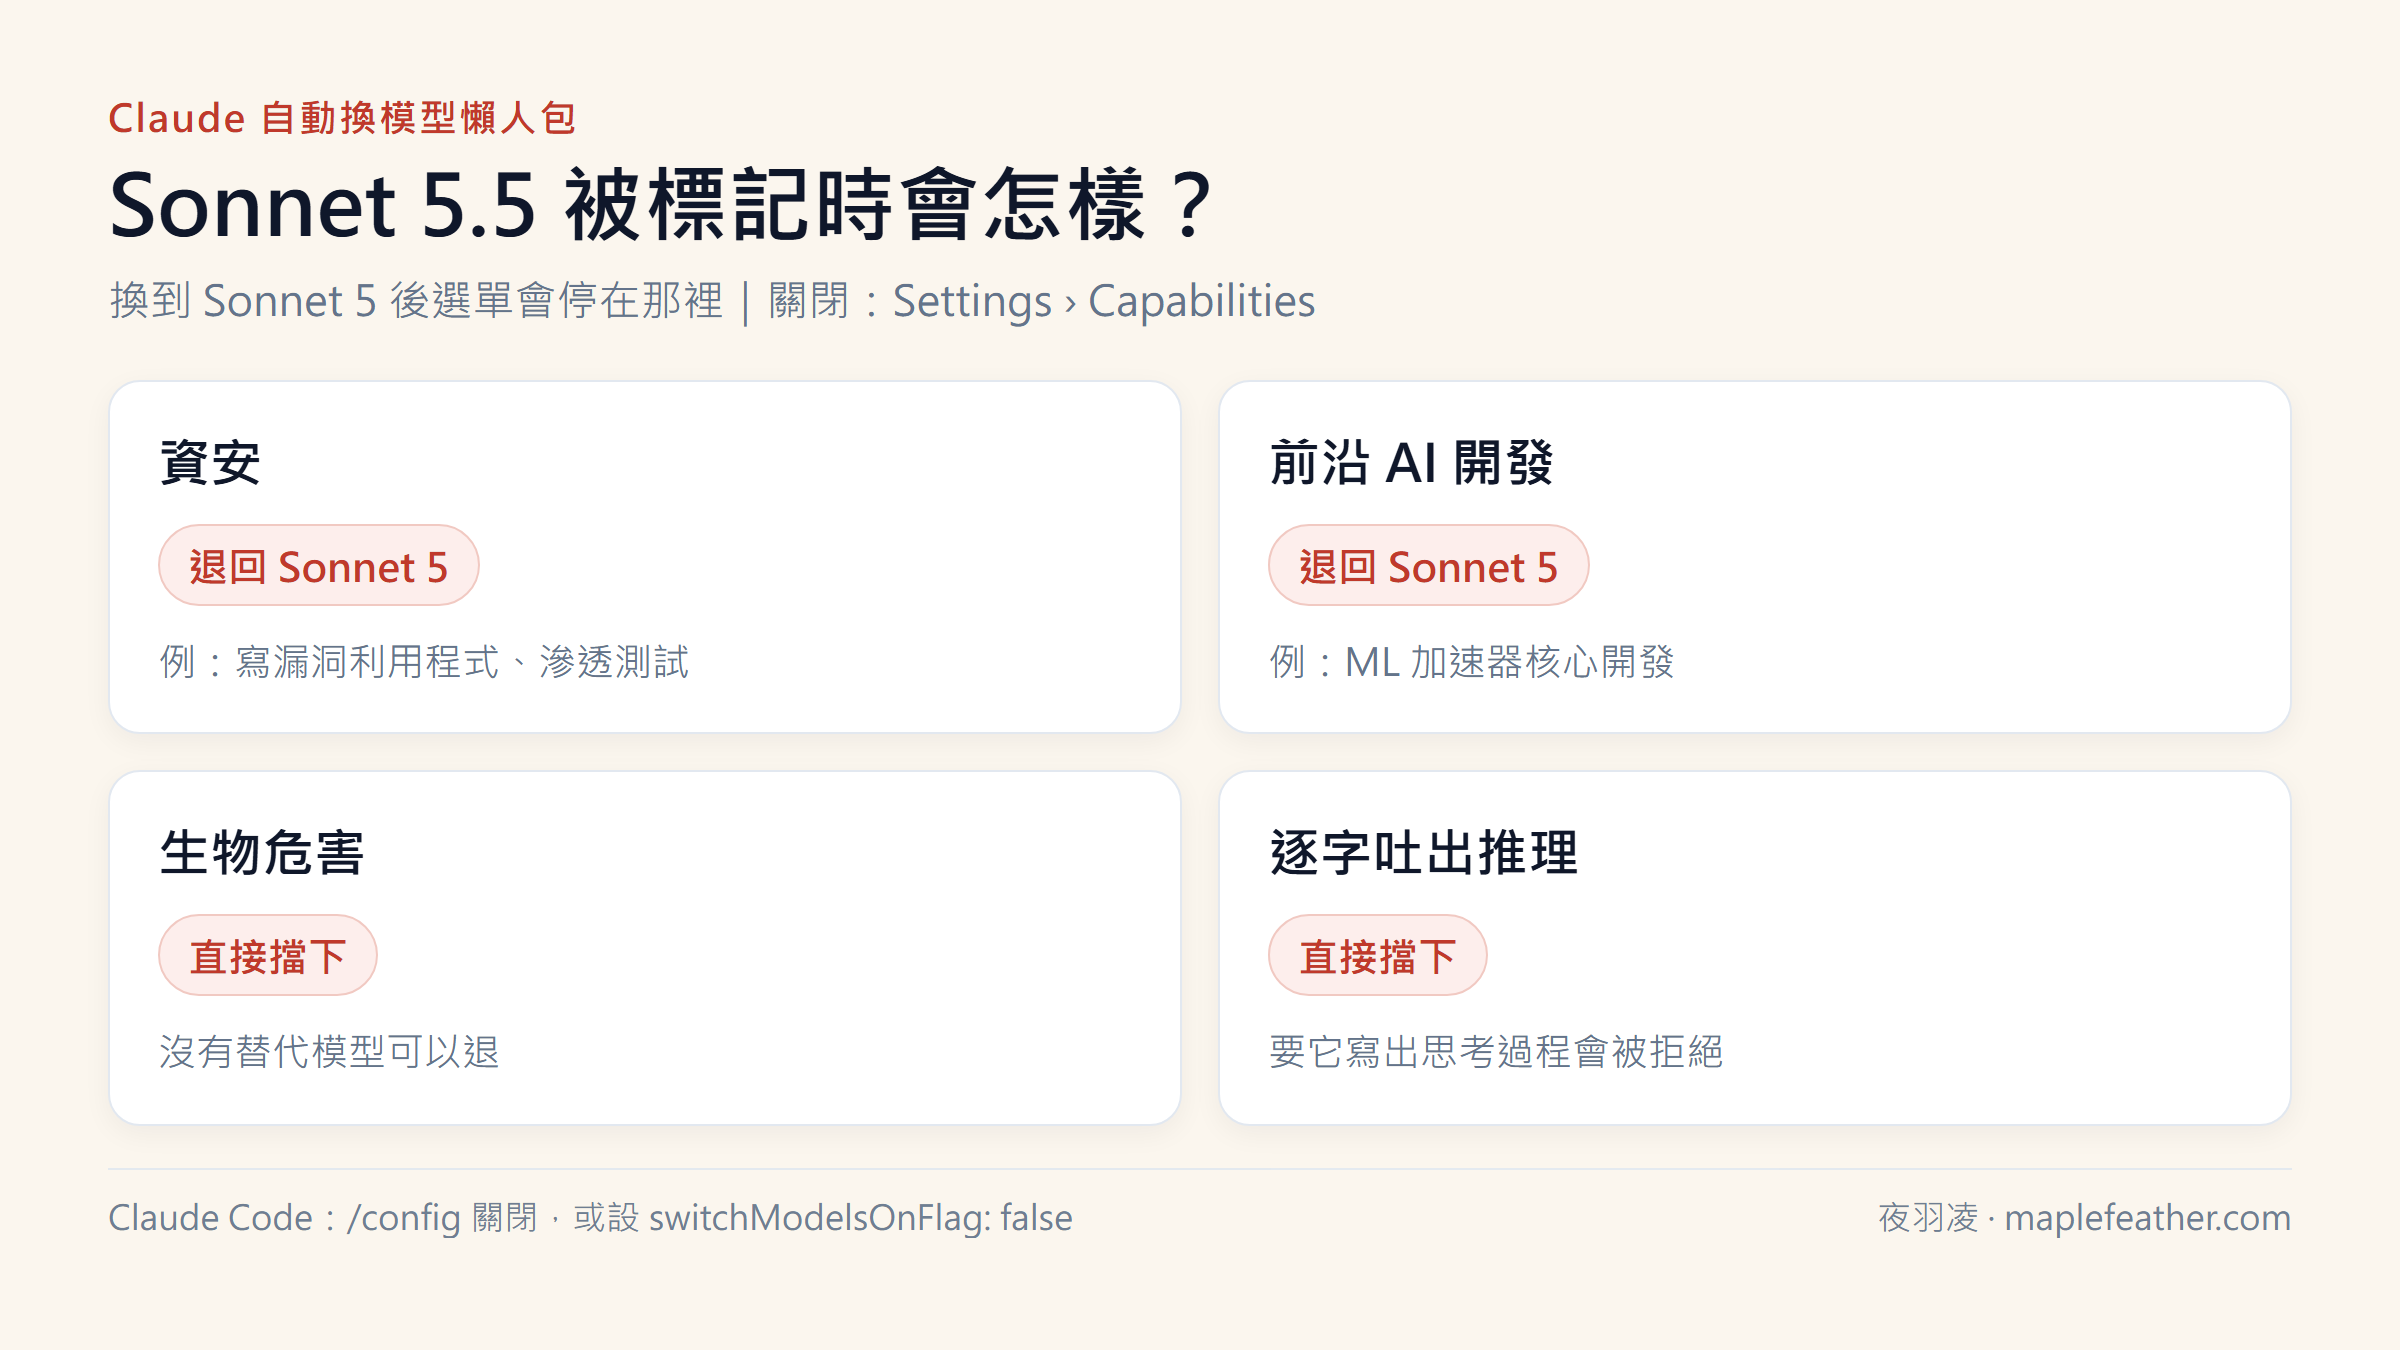
Claude 自己換成 Sonnet 5,是因為 Sonnet 5.5 的安全分類器把對話內容標記成高風險類別(檢查範圍包括記憶、連接器、搜尋結果和檔案),系統改用 Sonnet 5 回答;最麻煩的是換完之後,App 的模型選單會在這個對話裡一直停在 Sonnet 5,不會自己換回來。
會觸發的有四類。資安(例如寫漏洞利用程式、滲透測試)和前沿 AI 模型開發會退回 Sonnet 5;可能造成嚴重生物危害的請求直接擋下、不給替代;要求它把內部推理逐字寫出來的,也會直接擋。一般的安全寫碼、臨床或研究問題,說明頁寫明大多不受影響。
換模型時畫面會出現提示,那則回覆也會標上實際回答的模型。想回到 Sonnet 5.5,要自己到模型選單切回去;原本那則訊息還在對話裡的話,切回去可能又被換走,先改寫那則再重試比較有效。
那則 Sonnet 5 的回覆照 Sonnet 5 的價格另計,因為換模型而沒吃到快取的部分,Anthropic 會補 credit。
不想被自動換,可以到 Settings > Capabilities 把「Switch models when a message is flagged」關掉;Claude Code 則在 /config 關同一個選項,或在設定檔把 switchModelsOnFlag 設成 false。
關掉之後,被標記時會停下來問你:切到替代模型,還是改寫提示用原本的模型重試。
我比較喜歡「先問我」這種,至少我知道現在是誰在回答。Claude Code 還有一個更隱形的版本:被換過一次之後,整個工作階段都留在 Sonnet 5,要打 /model 才換得回來。
第一個請求就可能中招。Claude Code 的第一個請求會一起帶上 CLAUDE.md 和 git status,專案裡本來就放著資安或生物相關內容的,光是這些上下文就足以觸發,你什麼特別的話都還沒說。
做遊戲的人應該很有感:反作弊、外掛偵測的程式碼,長得跟攻擊工具非常像。
做資安、反作弊或 CTF 練習的讀者,建議先用 claude --safe-mode 開一次,它會暫時停用 CLAUDE.md、skills、MCP 和 hooks,確認是不是這些設定在觸發,再決定要不要把自動切換改成「先問我」。
Claude Code 怎麼切 Sonnet 5.5?/model、opusplan 和一個別名陷阱
在 Claude Code 輸入 /model sonnet 就會切到 Sonnet 5.5,但前提是你走 Anthropic 自家帳號或 API。Pro、Max、Team、Enterprise 的預設模型其實是 Opus 5.5,要用 Sonnet 5.5 得自己切。
常用的切換方式有四種,優先順序由高到低:
- 工作階段中:/model sonnet 立刻切換,而且會存成之後新工作階段的預設;只想這次用,打 /model 開選單、在那一列按 s
- 啟動時:claude --model sonnet
- 環境變數:ANTHROPIC_MODEL=sonnet
- 永久設定:寫進設定檔的 model 欄位
別名陷阱要特別講:同一個 sonnet,在 Anthropic API 是 Sonnet 5.5,在 Claude Platform on AWS 是 Sonnet 4.6,在 Amazon Bedrock、Google Cloud 和 Microsoft Foundry 是 Sonnet 4.5。
公司走雲端平台的,請直接寫完整模型 ID,不然你以為在用新模型,跑的其實是舊了一到兩個世代的 Sonnet 4.6 或 4.5。
整天待在 Claude Code 的人,最省事的是 opusplan:規劃模式用 Opus 5.5 想清楚架構,執行時自動換成 Sonnet 5.5 寫程式。我自己的分工是另一個方向,我把需要圖片的任務先丟給 Codex,再用 Claude Code 細修,為的就是省 Claude 的額度。
兩種分工的邏輯一樣:便宜的那支負責粗胚或執行,貴的那支只花在需要判斷的地方。兩個模型怎麼分工才不會付兩份錢,我在Claude Code 接 Codex 的額度那篇算過,道理跟 opusplan 是一樣的。
想再往下分一層,可以搭 advisor(顧問)工具排成三層:主模型 Sonnet 5.5 跑日常、卡關或要下判斷時交給 Opus 5.5 當顧問、子代理全用 Haiku 5.5。社群開發者 Daniel San(@dani_avila7)2026 年 10 月分享過這套設定,寫進設定檔就是這幾行:
{
  "model": "sonnet",
  "advisorModel": "opus",
  "env": {
    "CLAUDE_CODE_SUBAGENT_MODEL": "haiku",
    "CLAUDE_CODE_SUBAGENT_MODEL_FORCE": "1"
  }
}
這幾個鍵都是官方設定(2026 年 11 月 8 日對照advisor 文件與子代理文件):advisorModel 設 opus,就是讓 Opus 5.5 當顧問,在工作階段裡打 /advisor opus 也行;CLAUDE_CODE_SUBAGENT_MODEL 只是子代理的預設,加上 FORCE 那一行,連定義裡指定了別的模型的自訂子代理、內建的 Explore 也會一起強制改跑 Haiku,而且子代理也會沿用同一個顧問。
顧問只在 Anthropic 自家帳號或 API 上能用,環境裡設了 DISABLE_TELEMETRY 就不會啟動。Claude 只在要下判斷的節點才去問它,每次諮詢照 Opus 5.5 的費率算,訂閱方案則算進用量額度。官方建議用在大型重構、同一個錯誤一直重來這種長任務;短任務、或每一步都要最強模型的工作,直接 /model opus 比較乾脆。官方只說這樣通常比全程跑 Opus 便宜,沒給比例,整週下來省多少要看你的任務組成。
Claude Code 裡 Sonnet 5.5 的預設 effort 是 medium,文件形容這一檔適合「範圍清楚的日常工程」,例如實作一個新功能。這剛好是它最強的區間,不必急著往上調。
它有個小習慣要先知道:寫程式時會主動補測試、文件和小檔案,每一檔 effort 都會,effort 越高越多。多數團隊會樂見,但如果你只想改到你說的範圍,可以在 CLAUDE.md 加一句:
要求的事做完並檢查過就停下來回報,不要加沒被要求的功能、測試、檔案、文件或重構;覺得有幫助,最後提一句就好。
額度撞牆時 Claude Code 會不會自己等重置接著跑,是另一個常被誤會的地方,我在〈它是等重置、不是幫你付錢〉那篇寫過。現在先打開 Claude Code 打一次 /model,看清楚是誰在跑,再決定要不要改成 opusplan。
API 從 Sonnet 5 換到 Sonnet 5.5:這 5 個設定會直接報錯
這段寫給自己串 API 的開發者,只用網頁、App 或 Claude Code 的,可以直接跳到下一段的分流規則。
從 Sonnet 5 換到 Sonnet 5.5,除了改 model ID,有 5 個設定會直接回 400 錯誤,另有 1 個變化不報錯、卻會讓進度文字消失。
❶ 關思考改用 between_tools:送 thinking: disabled 會回 400,要改成 {"type": "between_tools"};它只收 low、medium、high,要開 xhigh 或 max 就得用 adaptive。
❷ 不能強制呼叫工具:tool_choice 設成 any 或指定某個 tool 會回 400,改用 auto 搭配 strict tool use,或改走 structured outputs。
❸ thinking block 綁模型與對話:2026 年 8 月 31 日(UTC)當天或之後建立的帳號,在 Claude API、Bedrock 和 Google Cloud 上,改過 system、tools 或前面的訊息再重送舊的 thinking block,會回 400。
對話要保持只往後加,要改指令就用對話中途的系統訊息,不要回頭改前面。
❹ computer use 換工具組:Claude API 和 Google Cloud 不再接受 computer_20251124,要改用 computer_toolset_20260801;Amazon Bedrock 照舊能跑,跨平台時行為會不一致。
❺ advisor 工具的配對:Sonnet 5.5 當執行者時,Opus 4.8、Opus 4.7 和 Sonnet 5 不能再當顧問。
比 400 更難抓的是第六件事:工具呼叫之間那些超過一兩句的進度說明,現在改放在 thinking block 裡,預設 display 是 omitted、內容是空的。你的介面如果會把這些話串流給使用者看,換過去之後那段文字就不見了,而且不報任何錯。
我帶產品上線這麼多年,最怕的從來不是會報錯的變更,是這種不報錯、只讓畫面安靜下來的。使用者不會回報「進度文字不見了」,他們只會覺得你的產品變慢、變笨。
從更舊的版本搬過來還要多看帳單:Sonnet 4.6 以前沒寫 thinking 的請求,到 Sonnet 5.5 也會思考,思考的 token 以輸出價計;而且同一段文字會多出約 30% 的 token,從 Haiku 4.5 搬過來也一樣。
設定上,非預設的 temperature、top_p、top_k 也要拿掉;Sonnet 4.5 以前的 assistant prefill 得換掉。
懶得一條條改的,Claude Code 裡有現成的遷移指令:/claude-api migrate this project to claude-sonnet-5-5。它會先問你要改整個目錄還是指定檔案,改完再給一份要人工確認的清單。
Sonnet 5.5 還是 Opus 5.5?我的分流規則(適合誰、不適合誰)
我的分流規則只有一句:任務講得清楚、做錯可以重來的,交給 Sonnet 5.5;需求模糊、要跑很久、做錯代價很高的,交給 Opus 5.5。跑分和價格都只是在幫這句話找證據。
✅ 適合交給 Sonnet 5.5
- 修一個已經知道在哪裡的 bug,手邊有測試可以驗收
- 照明確規格做文件、簡報、試算表
- 大量、重複、可以抽查的 API 任務,像分類、摘要、格式轉換
- 免費版的日常問答與寫作
❌ 先留給 Opus 5.5
- 「幫我想想這個架構怎麼設計」這種沒有標準答案的題目
- 要自己跑很多步、中途沒人盯的長任務
- 一步錯就得整批重做的重構或資料處理
- 已經把 Sonnet 5.5 開到 high 還是過不了的題目
Sonnet 5.5 如果因為任務講不清楚得多跑一次,那一半的單價優勢就歸零。與其省那一半單價,我寧可先花 10 分鐘把需求寫清楚。
如果你是:
- 每天在 Claude Code 裡修 bug、補功能,手邊有測試可以跑的工程師
- 用免費版寫報告、整理資料,常卡在額度邊緣的上班族
- 要跑大量分類或摘要、每個月盯著 API 帳單的小團隊
Sonnet 5.5 很值得當你的主力,前提是 effort 停在 medium 或 high、任務講清楚;真的做不動再切回 Opus 5.5(免費版沒有 Opus,就換個問法重問)。挑一個本週一定會做的任務,兩款用同一個 effort 各跑一次,比結果,也比 token 數。
👉 打開 Claude.ai,把模型切到 Sonnet 5.5 試一個任務
FAQ 常見問題
Sonnet 5.5 跟 Sonnet 5 差在哪?還需要留著 Sonnet 5 嗎?
單價與斷詞器都一樣,Sonnet 5.5 輸出快 30% 以上、同樣的工作最多少花 30%,程式和操作電腦都大幅進步(CursorBench 34.1%→55.5%、OSWorld 57.0%→80.1%)。
Sonnet 5 仍在舊版模型名單裡,也是 5.5 被安全分類器標記時的退回對象。
API 端除非還離不開 thinking: disabled、強制工具呼叫、舊版 computer use 工具或舊的 advisor 配對,否則沒理由留著。上一代的評價可以看我寫的Sonnet 5 升級前要先看的那個陷阱。
Sonnet 5.5 和 GPT-6 Sol 都是 2 美元,該選哪個?
短上下文兩者價格一模一樣:輸入 2 美元、輸出 10 美元、快取讀取 0.20 美元、寫入 2.50 美元。差在長上下文:GPT-6 Sol 超過 272K 整筆變成 4 美元/15 美元,Sonnet 5.5 的 1M 全程同價。
我拿 50 萬輸入加 2 萬輸出算下來,Sonnet 5.5 是 1.20 美元、Sol 要 2.30 美元。所以短對話多半打平,選你習慣的那家就好;常丟超過 27.2 萬 token 的長文件,Sonnet 5.5 比較省。
Sol 的額度與差別我整理在GPT-6 Sol、Luna 差別與費用那篇。
撞到 Opus 上限時切 Sonnet 5.5,會比較省額度嗎?
會讓你繼續做事,但不會讓額度變多。Claude Code 的 Opus、Sonnet 家族上限各自計算,切到家族外的模型就能繼續;全模型共用的 session 與每週上限,換模型也救不了。切過去的第一個請求會整段重讀、沒有快取命中,最好在一段工作告一段落時再切。
Haiku 4.5 要換 Sonnet 5.5,還是等 Haiku 5.5?
重視成本的大量任務,不用再等了:Haiku 5.5 已在 2026 年 10 月 7 日推出,提示在 10 萬 token 以內,每百萬 token 輸入 0.10 美元、輸出 0.50 美元,超過 10 萬則是 0.50 美元/2.50 美元,兩種情況的單價都比 Haiku 4.5 低。
Haiku 4.5 是 1 美元/5 美元,Sonnet 5.5 貴一倍,而且同一段文字多出約 30% 的 token,沒寫 thinking 的請求也會思考、思考以輸出計價,帳單會漲得比單價更多。
Haiku 4.5 官方只寫「最快 2026 年 10 月 15 日」退役,2026 年 11 月 8 日查證時還在服務、沒公布確切日期,遷移計畫還是現在就該排。
Claude Code 要不要全面改用 Sonnet 5.5?
不必全面換。訂閱戶的預設是 Opus 5.5、effort medium,本來就不算浪費;比較好的做法是開 opusplan,讓 Opus 5.5 規劃、Sonnet 5.5 執行,或在撞到 Opus 上限時切過去收尾。資安相關的專案,記得先把自動切換改成「先問我」。
結論:Sonnet 5.5 省的是單價,effort 得你自己管
Sonnet 5.5 是我覺得這幾代裡最划算的 Sonnet:單價沒漲、速度更快,日常任務的能力幾乎貼著 Opus 5.5。但它不是自動省錢的按鈕,effort 開到頂、任務講不清楚、在長對話中間亂切模型,都會把那一半的單價優勢吃掉。
AI 沒有讓人更清閒,反而讓我更忙了,每出一個新模型,就多一組帳要重算。算完之後,規則其實很簡單:講得清楚的交給 Sonnet 5.5,講不清楚的留給 Opus 5.5,effort 永遠自己寫。
想在下一次模型換代時也收到這種「帳算完的版本」,訂閱我的部落格,會不定期收到信。想知道我平常怎麼用 AI 工作、為什麼同時付兩份高階訂閱,可以看夜羽凌的自我介紹。
參考資料
- Anthropic:Introducing Claude Sonnet 5.5
- Anthropic:Claude Sonnet 產品頁
- Claude Platform Docs:What's new in Claude Sonnet 5.5
- Claude Platform Docs:Models overview
- Claude Platform Docs:Prompting Claude Sonnet 5.5
- Claude Help Center:Why Claude switched models in your conversation with Sonnet 5.5
- Claude Help Center:Claude Enterprise consumption guide
- Claude Code Docs:Model configuration
- Claude Code Docs:Errors(用量上限訊息)
- Artificial Analysis:Claude Opus 5.5
- TechCrunch:Anthropic releases Sonnet 5.5
- Unite.AI:Claude Sonnet 5.5 at unchanged Sonnet 5 pricing
- Anthropic:Supported countries and regions
※ 文中 Claude Sonnet 5.5 主視覺與示範畫面為 Anthropic 官方宣傳素材(來源:anthropic.com,版權所有 © Anthropic);Sonnet 5.5 自動換模型懶人包為夜羽凌自製。