💡 核心結論速覽 (TL;DR)
- Jev 是什麼:TypeSafe AI 在 2026 年 9 月 15 日發布的 System One 模型,只回傳「選項、分數、機率」,完全不生成文字,輸入每百萬 token 0.042 美元、輸出免費。
- 省多少:用官方範例算,一萬次判斷 Jev 要 0.16 美元、Claude Haiku 4.5 要 8.75 美元、Fable 5.1 要 87.5 美元。官方講的 444 倍是拿最貴那檔比的,對照最便宜的 Haiku 只有 53 倍。
- 最大的誤會:它不會寫程式,Claude Code 週額度用完了改用 Jev 沒有用。它省的不是每個 token,是讓貴的模型少被叫幾次。
- 先做這件事:去控制台複製右側 Quickstart 那段提示詞,貼給 Claude Code、Codex 或 Antigravity,它會自己裝完;帳號裡那 5 美元是月度額度,30 天不用就歸零。
我同時付 ChatGPT Pro 和 Claude Max 20x,兩邊各 200 美元一個月。就算付到這個檔次,我還是會在週四下午看到那行「額度快用完」。
所以當 TypeSafe 丟出一個「只做判斷、不寫字、輸出免費」的模型時,我第一個反應不是它有多新,而是——我那些每天跑上千次、只是要一個是或不是的步驟,是不是根本不該佔用 Claude 的額度?
我申請進去了,也把它裝進 Claude Code 和 Antigravity 試過。這篇把帳算給你看,也把安裝指令、三種題型、官方自己承認的六個弱點,還有中文那個不能忽略的但書,一次講完。
但先講最重要的一句,免得你看完去試才發現不對:Jev 不會寫程式,也不會回答問題。它接不走 Claude Code 的工作,只接得走 Claude Code 「順手幫你做的那些判斷」。這兩件事差很多,我們從這裡開始講。
Jev 是什麼?一句話:它是只會做選擇題的 AI,不會寫作文
Jev 是 TypeSafe AI 在 2026 年 9 月 15 日發布的第一個 System One 模型,目前是早期存取階段。它不生成文字,你給它一段材料和幾個問題,它直接回傳型別化的答案加上機率。
你可以把現在的 AI 分成兩種工人。一種是會寫作文的,你問它什麼它都能講一段——ChatGPT、Claude、Gemini 都是這種。另一種只會劃卡,題目給它,它回答 A、B 還是 C,然後告訴你它有幾成把握。
Jev 是第二種。而且它只會第二種,你叫它寫一段話它做不到,因為它沒有被訓練來生成文字——這是官方自己在模型說明裡寫的。
聽起來像退化對吧?我一開始也這樣想。但你回頭看自己的 AI 流程就會發現,裡面有一大堆步驟根本不需要作文能力:
- 這封信急不急?
- 這段改動有沒有動到資料庫?
- 這則留言要分給客服還是業務?
- 這篇搜尋結果跟使用者問的有沒有關係?
這些全部都是選擇題。但你現在的做法八成是——叫一個會寫作文的模型去劃卡,還要求它「只回 JSON、不要多說廢話」,然後祈禱它這次真的沒多說。
這就是最貴的地方。你付錢請它想,付錢請它寫,寫完還要自己 parse,parse 失敗還要重跑一次。Jev 把這段整個拿掉:它的回傳本身就是資料結構,沒有格式錯掉這回事,因為它根本沒有「格式」可以錯。
三種題型就三種,Noul(是非題,回是的機率)、Choice(選擇題,回選項加機率分布)、Score(評分題,回一個位置加分布)。後面有一整段專門講怎麼挑,先記得這句話就好:能被寫成選擇題的,就別再叫作文機了。
為什麼 Claude、Codex 的額度總是不夠用?因為有一段工作根本不需要它們做
Claude Code 和 Codex 的額度撐不到週末,通常不是因為你寫的程式太難,而是因為你讓同一個頂級模型同時做了兩種難度天差地遠的事。
我自己的用法是這樣:需要生圖的任務我先丟 Codex 做粗胚,再用 Claude Code 細修,就是為了省 Claude 的 token。這個分工我用了一陣子,效果是真的——我一向是那種先用便宜的把粗胚做出來、貴的只拿來細修的人,省下來的額度可以多跑幾輪。
但我之前漏掉了第三層。粗胚和細修都還是「產出」,而在產出之間,模型還在不停做判斷:這步做完了沒?要不要再跑一次測試?這個錯誤要不要回報給使用者?這些判斷每一次都在燒你的週額度,而它們全部都是選擇題。
順帶一提,如果你還在疑惑自己的額度為什麼比去年更緊,那不是錯覺:Claude Code 的標準週上限在 9 月 14 日永久改制,官方自己承認實際少了約 17%。撞牆時間提前半天到一天,很多人就是在那半天裡被卡住的。
這裡要先設一道誠實的閘門,不然你會白試一場:
| 你的痛點 | Jev 接不接得走 | 為什麼 |
|---|---|---|
| Claude Code 週額度用完,不能寫程式 | ❌ 接不走 | Jev 完全不產生程式碼或文字 |
| 在 App 裡跟 AI 聊天撞到上限 | ❌ 接不走 | 它沒有對話介面,只有 API |
| 自己寫的流程裡,拿 LLM 當分類器那幾步 | ✅ 直接換掉 | 那幾步本來就是選擇題 |
| Agent 一直在判斷「做完了沒、該呼叫哪個工具」 | ✅ 換掉最有感 | 控制層的判斷量遠大於產出量 |
| 一萬筆資料要先篩出該處理的那幾筆 | ✅ 省最多 | 先篩再叫 LLM,呼叫次數直接砍掉九成 |
所以正確的期待是這樣一句話:Jev 省的不是「每個 token 更便宜」,是「讓貴的模型少被叫幾次」。它不會讓你的週額度變長,但會讓你不再拿週額度去做它根本不該做的事。
如果你現在卡的是純粹的額度不夠,那先看我把 Codex 四個免費回血管道整理過一輪,順便踩到那個 30 天就作廢的坑,那篇處理的是「怎麼拿到更多」;這篇處理的是「怎麼少用一點」。兩個方向要一起做才有效。
Jev 價格多少?我把一萬次判斷的帳單攤開,官方的 444 倍我只算出 53 倍
Jev 的價格是輸入每百萬 token 0.042 美元,輸出完全免費。這個「輸出免費」不是促銷,是它的計費設計——因為它沒有輸出 token 可言,回傳的是結構化的值。
官方在發表文裡的說法是「193.6 倍快、444.6 倍便宜」。但你要先知道那個數字怎麼來的:基準是 GPT-6 Astra 和 Claude Fable 5.1,任務是 TypeSafe 自家首頁的工作流評測,不是公開 benchmark。
那如果拿你實際會用的那一檔來比呢?我用官方 quickstart 的範例當基準——一封客服信,同時問三題(該分給哪個部門、客戶多不爽、有沒有急迫性),官方回傳的用量是輸入 392 個 token、輸出 65 個。
然後我把同一件事換算成四家的帳單。LLM 這邊我多抓了 150 個 token 給 JSON 格式指示(不給它這段,它回來的東西你 parse 不了),輸出抓一樣的 65 個:
| 模型 | 輸入/百萬 | 輸出/百萬 | 一萬次帳單 |
|---|---|---|---|
| Jev 1.13 | $0.042 | 免費 | $0.16 |
| Claude Haiku 4.5 | $1 | $5 | $8.75 |
| Claude Sonnet 5 | $2 | $10 | $17.50 |
| Claude Opus 5 | $5 | $25 | $43.75 |
| Claude Fable 5.1 | $10 | $50 | $87.50 |
算式攤開給你對:Jev 是 392 × 0.042 ÷ 100 萬 × 1 萬 = 0.16 美元。Haiku 4.5 是(550 × 1 + 65 × 5)÷ 100 萬 × 1 萬 = 8.75 美元。同樣一件事,倍數是 53 倍。
對到 Fable 5.1 那格,我算出來是 531 倍——跟官方的 444.6 倍同一個量級,所以官方沒有灌水,它只是挑了最貴的那把尺。
這裡有個陷阱,我在算 DeepSeek 那次漲價的帳時就踩過一次:看到聳動的倍數,第一件事是問「那一格本來多少錢」。53 倍聽起來很多,但絕對金額是從 8.75 美元變成 0.16 美元,一萬次判斷省下 8.59 美元,大概 275 塊台幣。
一個月一萬次判斷,省 275 塊。你確定值得為此多接一個 API、多一組金鑰要管、多一個會掛掉的外部相依嗎?我的答案是不值得。這個門檻後面有一整段專門算。
順帶補一個比錢更有感的維度:速度。官方給的數字是 Jev 70 到 500 毫秒,同樣的工作交給前沿 LLM 是 3 到 329 秒。如果你的判斷卡在使用者正在等的那一秒,這個差距比帳單重要得多。
Jev 怎麼申請帳號?那個 Join Waitlist 的小視窗我找了半天
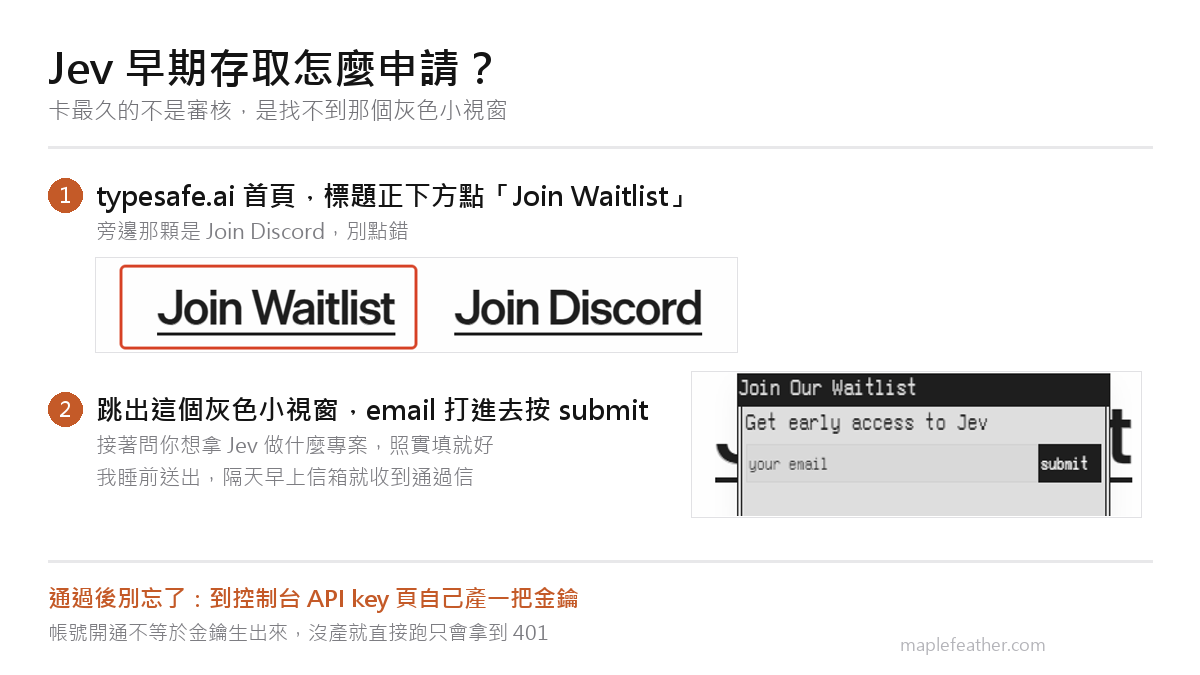
Jev 現在是早期存取,申請入口就在 TypeSafe 官網首頁標題下方那個「Join Waitlist」,旁邊還有一個「Join Discord」。整個流程只要填 email 加幾題問卷。
老實說我卡在第一步卡了一陣子。點下去之後會跳出一個很小、灰灰的復古風格小視窗,標題寫「Join Our Waitlist / Get early access to Jev」,下面一格 email 輸入框加一顆 submit。
那個視窗實在太不像現代的申請表單,我一直以為只是裝飾,眼睛就這樣滑過去好幾次,還跑去翻有沒有別的註冊頁。如果你也找不到,答案就是那個灰框,email 直接打進去按 submit 就對了。
送出後會接著問幾題,例如你打算拿 Jev 做什麼樣的專案。照實填就好,不用寫成提案簡報——你寫得越具體,對方越知道要不要放你進來。
審核速度我自己的體感是很快:我睡前送出,隔天早上打開信箱就看到通過信了。大約一個晚上。當然這是單一樣本,不保證每個人都一樣,但至少不是那種送出去石沉大海的等待。
拿到開通信之後,記得還要做一件很多人會漏掉的事——去控制台的 API key 頁自己產一把金鑰。帳號通過不等於金鑰生出來,沒產就直接跑,回來的只會是 401。
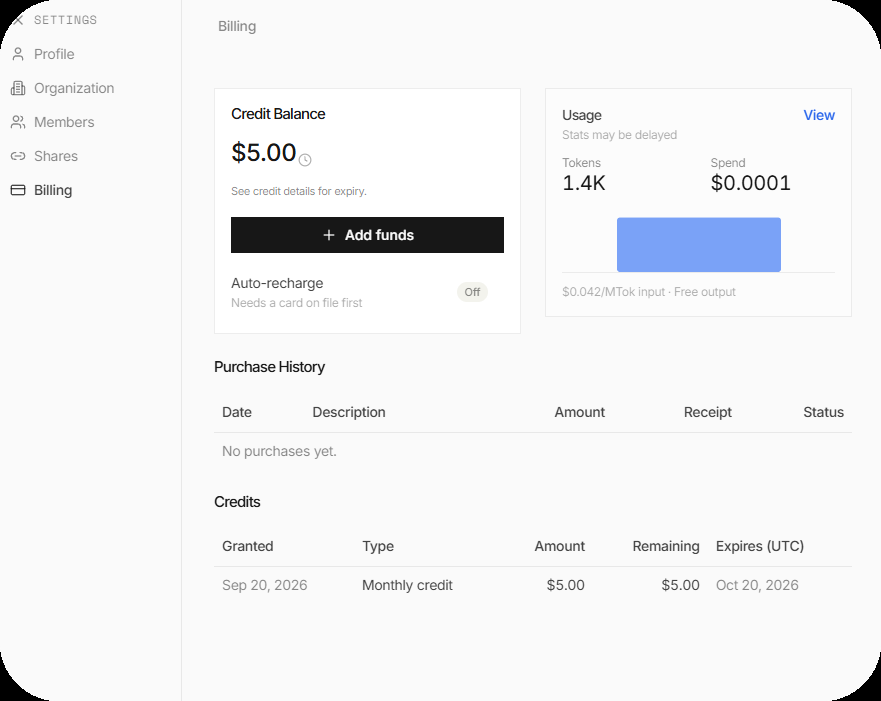
註冊送的 5 美元能跑多久?我後台是 30 萬次判斷,但下個月 20 號就過期
Jev 帳號開通後會有一筆 5 美元的額度,但它在後台的欄位寫的是「Monthly credit」,而且標了到期日——我的帳號是 9 月 20 日發放、10 月 20 日到期。
這筆錢能跑多少?我用上面同一個基準算:5 ÷ 0.042 × 100 萬 = 1.19 億個輸入 token,除以每次 392 個,等於大約 30 萬次判斷。
30 萬次是什麼概念?同樣的量丟給 Claude Haiku 4.5,你要付 266 美元。也就是說,官方送你的這 5 塊錢,在 Haiku 那邊價值 8,500 塊台幣。拿來做完整的樣本測試綽綽有餘。
但那個「Monthly」和到期日,就是我要提醒你的坑。
我第一眼看到 5 美元時,直覺是「註冊禮,慢慢用」。點進 Credits 那張表才發現它寫 Expires——這跟我之前在 Codex 那邊差點放到過期的重置券,是一模一樣的坑型:不是沒給你,是給了你不知道要用。
老實說我對這種設計沒什麼好感,但它確實有效——會逼你在第一個月就真的跑一輪測試,而不是把它放到忘記。
這裡要誠實說一件事:官方文件沒有這一頁。我試過 docs.typesafe.ai/billing 和 /pricing,兩個都是 404。所以「是不是每個月都會給」「早期存取結束後還有沒有」,官方沒有公開說明,我看到的只是我自己帳號在 9 月 20 日的狀態。
你自己進去之後,第一件事就是去 Billing 頁確認你那筆的到期日,不要照抄我的。
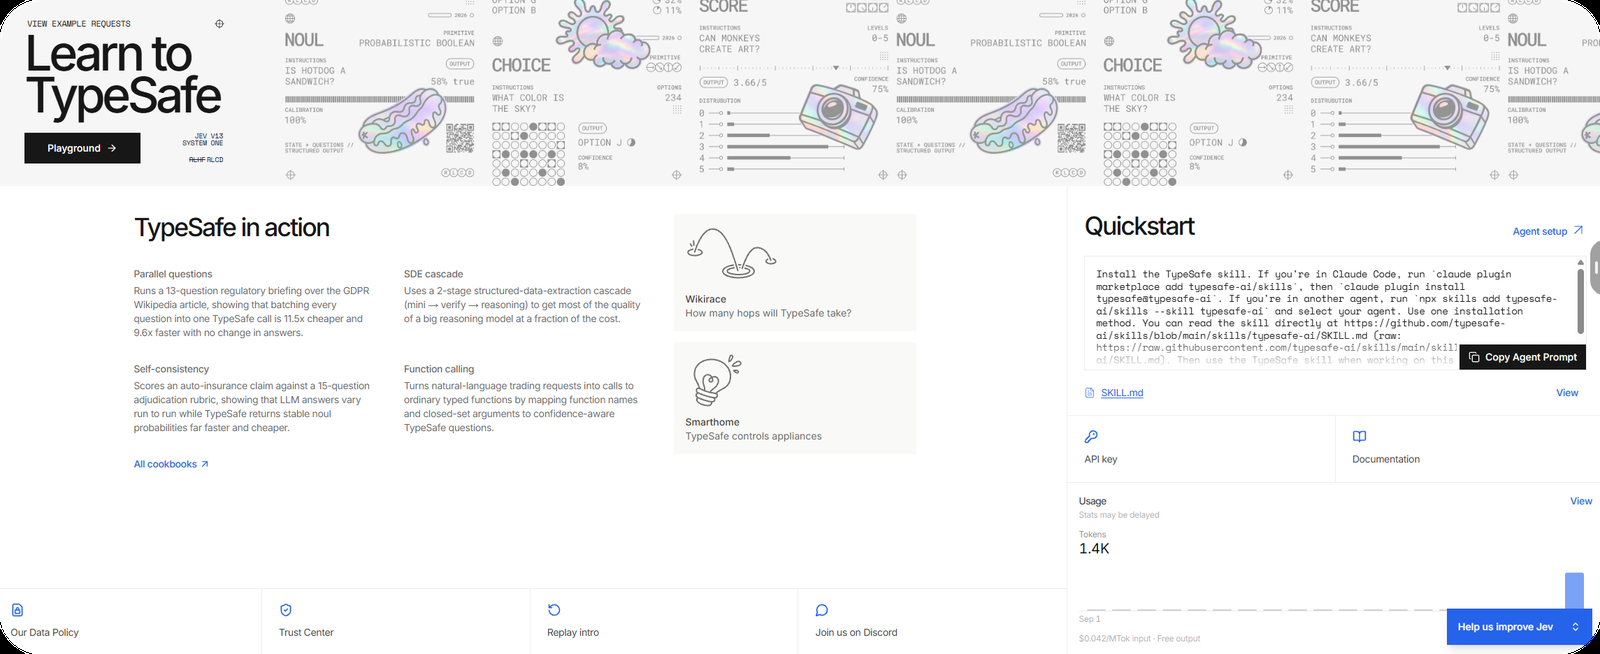
Jev 怎麼串接?我分四層講,第一層完全不用寫程式
Jev 開通後進控制台,右側就有一塊 Quickstart 面板,裡面那段指令可以直接複製給你的 AI 工具,它會自己裝完。你不用從頭做到尾,從哪一層進場都可以。
❶ 第一層:Playground,完全不用寫程式
控制台左上角有個 Playground 按鈕。進去把任何一段文字貼進 state,然後加一題,例如「這段話有沒有表達急迫性?」按下去就會看到回傳的機率。
這一層的價值不是玩,是讓你在寫任何程式之前,先確認你腦中那個問題到底問不問得清楚。我自己試的時候就發現,我想問的和我寫出來的,常常差了半句話。
❷ 第二層:把 Quickstart 提示詞貼給你的 AI 工具,讓它自己裝
這是我覺得最值得推的一層,因為你一行指令都不用自己打。控制台 Quickstart 面板右下角有「Copy Agent Prompt」按鈕,複製完貼給 Claude Code、Codex 或 Antigravity 就好。
那段提示詞實際做的事情是這三條,你也可以自己打:
- Claude Code:
claude plugin marketplace add typesafe-ai/skills,接著claude plugin install typesafe@typesafe-ai - Codex 或其他 agent:
npx skills add typesafe-ai/skills --skill typesafe-ai,跑完會問你要裝給哪個工具 - 裝完之後,在任務裡直接說「用 TypeSafe skill 做這件事」;Claude Code 也可以用
/typesafe:typesafe-ai叫它
官方那個 typesafe-ai/skills repo 目前 768 顆星,最近一次提交在 9 月 12 日,是官方自己維護的。
❸ 第三層:一個 curl 確認金鑰和網路都通
先去控制台的 API key 頁產一把金鑰——這一步很多人會漏掉,裝完 skill 沒產金鑰,跑起來只會拿到 401。產完之後設成環境變數,再打一次最簡單的請求:
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "state": "我被重複扣款了,希望今天就能處理。",
    "model": "jev-latest",
    "questions": {
      "is_urgent": {
        "type": "noul",
        "instructions": "這段訊息有沒有明確提出處理時間或截止時間?"
      }
    }
}'回來的東西長這樣,noul 就是「是」的機率,0 到 1 之間:
{
  "model": "jev-1.13.0",
  "answers": {
    "is_urgent": { "type": "noul", "noul": 1.0 }
  },
  "usage": { "input_tokens": 392, "output_tokens": 65 }
}這裡有個實用的小測試:把「希望今天就能處理」改成「不急,下週看也可以」,再跑一次。兩句都帶了時間資訊,所以照上面那個問法,兩句都可能拿到高分。如果你要的是急迫程度,那就得另外寫一題,不能靠這題。
這個小實驗花不到一分鐘,但它會直接讓你看懂 Jev 的脾氣——它回答你寫的問題,不是你想問的問題。
❹ 第四層:接進你的程式或 agent 工作流
Python 這邊 pip install typesafe-sdk 就好,需要 3.10 以上。client 會自己讀 TYPESAFE_API_KEY 這個環境變數,不用手動傳。
如果你想讓 Claude Code 或 Codex 在寫程式時自動叫它做品質評審,社群有個 jev-review 插件(171 顆星,9 月 17 日更新),用 npx plugins add NiazMorshed2007/jev-review --target claude-code 安裝,Codex 把最後那個參數換成 codex。
這裡有一個會讓你卡半小時的細節:官方 SDK 讀的環境變數是 TYPESAFE_API_KEY,jev-review 讀的是 JEV_API_KEY,兩個名字不一樣。裝完發現連不上,先看是不是這個。
另外提醒一句,這個插件是第三方的,不是 TypeSafe 官方維護;它會把你的任務說明和程式碼差異送到 Jev API。要接之前,先確認你送出去的那份 diff 裡沒有金鑰和不該外流的東西。
還有一條路是完全不碰 TypeSafe 帳號——Jev 已經上架 Cloudflare Workers AI,模型 id 是 typesafe/jev。如果你的東西本來就跑在 Cloudflare 上,這條路少一組金鑰要管。不過要注意那頁標的 context 是 32,000,跟官方 API 的 64,000 不一樣,別照抄上限。
說到金鑰,你現在手上至少會多兩組(TypeSafe 的、還有插件那組)。金鑰散在各個專案的 .env 裡是遲早出事的做法——我自己是全部收進密碼管理工具的開發者金庫,用 CLI 注入,本機不落地明文。1Password 的開發者金鑰管理就是做這件事的,一組金鑰要在三個 agent 之間共用時特別有感。
Noul、Choice、Score 三種題型怎麼選?一張表加一段能直接跑的程式
Jev 只有三種題型,選錯題型比問錯問題還常見。判斷方式很單純:看你要的答案「長什麼樣子」,不是看問題有多難。
| 題型 | 什麼時候用 | 回傳什麼 |
|---|---|---|
| Noul | 某個條件成不成立 | 是的機率(0 到 1),沒有另外的 confidence |
| Choice | 從你定義好的一組選項挑一個 | 選中的那個+每個選項的機率+confidence |
| Score | 在一條有順序的程度上定位 | 加權位置+各級距機率+confidence |
三種可以混在同一次請求裡,而且這件事非常重要:同一份 state 只會被讀進去一次,幾題一起問就一起算。官方自己的例子是把 13 題打包成一次呼叫,結果比分開問便宜 11.5 倍、快 9.6 倍,答案完全沒變。
所以「一次只問一題比較準」在這裡是錯的直覺。該拆的是問題本身的顆粒度,不是請求的次數。
下面這段是我調整過的客服分流範例,可以直接改字跑:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

response = client.system_one(
    state={"message": "我被重複扣款了,希望今天退回多扣的錢。"},
    questions={
        "intent": Choice(
            instructions="客戶的主要訴求是什麼?",
            criteria={
                "refund": "要求退回已經付出去的錢",
                "technical": "要求修復功能或連線問題",
                "information": "只是詢問資訊,沒有要求退款或修復",
                "other": "以上都不適合,或材料不足以判斷",
            },
        ),
        "urgency": Score(
            instructions="訊息表達了多強的處理急迫性?",
            criteria=[
                "沒有要求盡快處理,也沒提出近期期限",
                "希望盡快處理,或提出當天等近期期限",
                "明確要求立刻處理,並說明正在受到嚴重影響",
            ],
        ),
        "has_deadline": Noul(
            instructions="訊息有沒有明確提出處理時間或截止時間?"
        ),
    },
)

print(response.answers["intent"].choice)
print(response.answers["intent"].probabilities)
print(response.answers["urgency"].score)
print(response.answers["has_deadline"].noul)
這段程式裡有三個我建議你照抄的習慣:
❶ Choice 一定要留一個 other
範例裡的 other 是給接不住的訊息一個出口。你如果只列三個業務部門、卻逼它必選一個,程式拿到的仍然是合法答案,只是分錯部門——而且你完全不會發現。
❷ Score 的分數只在你這套級距裡有意義
上面三級對應 0、1、2。拿到 1.2 不能講成「急迫度 1.2 分、滿分 10 分」。你哪天改了級距描述,舊分數就失去比較基礎了,儀表板上的歷史曲線會變成謊話。
❸ 把模型版本記進 log
回傳裡有 model 欄位。同一題換模型版本,分數分布可能就變了。你之後要調門檻、要復現問題,這個欄位是唯一的線索。
我自己架過一套 AI 客服系統,最花時間的從來不是接 API,是這種「當初為什麼設這個值」的考古。能寫進 log 的東西就寫進去,一行的成本,換的是三個月後不用重猜。真的要自己架一套之前,先看我把 AI 客服機器人那 4 筆廠商不會告訴你的隱藏成本算過一輪,判斷模型只解掉其中一筆。
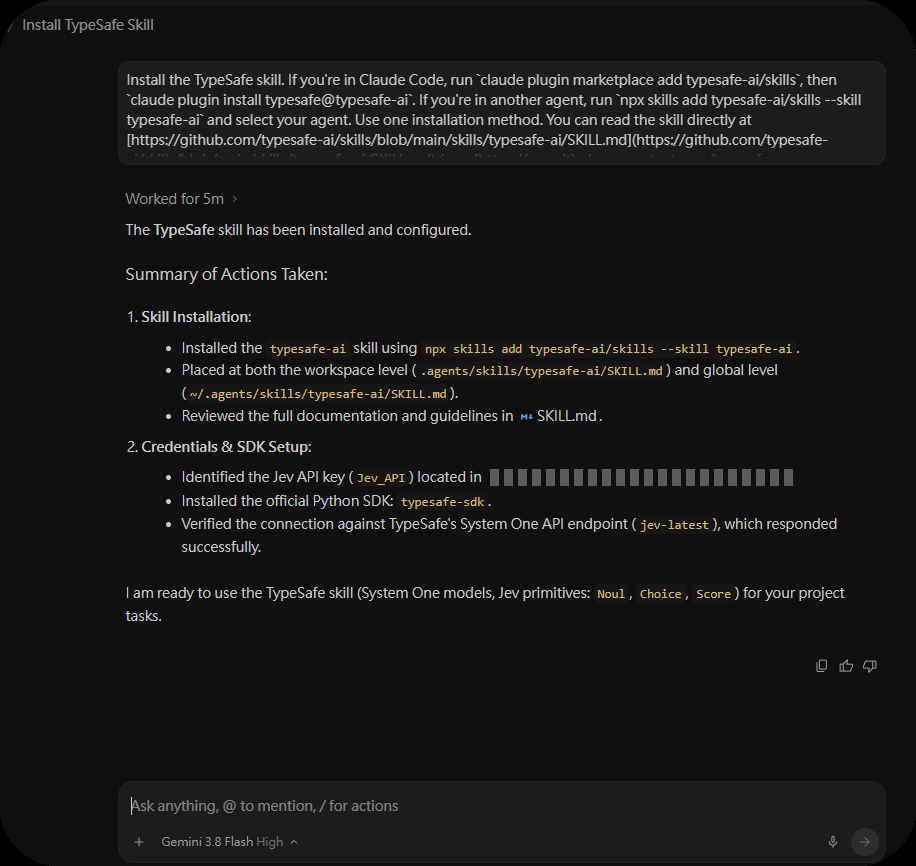
最快的大腦配上最快的嘴巴:我把 Jev 裝進 Antigravity,讓 Gemini Flash 只負責輸出
Google Antigravity 也裝得起來,而且這個組合是我目前試下來最有感的一種——Jev 負責判斷、Gemini Flash 負責輸出,整條任務的體感速度會快到有點誇張。
我的做法很懶:把控制台那段 Quickstart 提示詞複製下來,直接貼進 Antigravity 的對話框,模型選 Gemini 3.8 Flash(High)。然後就不管它了。
五分鐘後它自己回報裝完:用 npx skills add 把 skill 放進 workspace 和 global 兩層、讀完整份 SKILL.md、找到我的 API key、裝好 typesafe-sdk,最後還實際打了一次 jev-latest 端點確認連得上。我一行指令都沒打。
為什麼這個組合特別值得講?因為它剛好補上 Gemini Flash 最被詬病的那件事。
我之前拆過 Gemini 3.8 Flash 的帳單為什麼會比想像中貴,結論是:貴的不是它思考,是它多跑了幾趟。判斷得不夠好,就會多繞回合,回合一多,快就沒有意義了。
那如果判斷不交給它呢?Jev 70 到 500 毫秒回一個帶機率的答案,Flash 拿到答案直接輸出。判斷那一段不用推理、不用生成,回合數自然掉下來。
我腦中的畫面是這樣:最快的大腦配上最快的嘴巴。大腦只管決定往左還往右,嘴巴只管把話講漂亮,兩邊都不做對方擅長的事。
這個組合適合什麼?我的判斷是三種情況:
- 使用者正在等的互動場景:聊天機器人要先判斷意圖再回話,那個判斷不能讓人等三秒
- 批次處理:一萬筆資料先用 Jev 篩出該處理的,剩下的才叫 Flash 生成
- 你覺得 Flash 有點笨但捨不得它的速度:把需要動腦的那段外包出去,留它做它最擅長的輸出
但也有不適合的:如果你的任務本來就是一段連貫的推理(例如讀一份合約找出互相矛盾的條款),那拆成「判斷+輸出」反而會斷掉脈絡。這種就別拆,整包交給會推理的模型。
confidence 不是正確率,我會這樣設門檻
Jev 回傳的 confidence 是機率分布集中程度的統計量,不是「這個答案正確的機率」。這兩件事被搞混,是我看到最容易出事的誤解。
分布很集中,代表模型在它理解的那個問題裡答得很篤定。但如果你的問題本身寫歪了,它會非常篤定地答錯——而且 confidence 還是 0.95。
另外兩個細節也要記住:Noul 沒有 confidence 這個欄位,機率本身就是答案;而 Noul 落在 0.5 附近代表是與不是的機率差不多,不是「中等強度」。這個誤讀會讓你的門檻整個歪掉。
那門檻要怎麼設?官方的示範邏輯是兩層,我覺得很合理:
❶ 先設一個地板
confidence 低於 0.5 的,一律不自動處理,丟人工或丟給會推理的模型。這條是攔截「模型自己都說不準」的情況。
❷ 再依後果分層
同一套系統裡,不同動作要不同門檻。只是把資料標個顏色,0.6 就可以動;要把使用者的資料刪掉或把信寄出去,那就拉到 0.9 以上,低於就停下來問人。
❸ 別照抄任何人的數字,包括我的
官方自己也寫了這句。0.5 和 0.9 是示範值,不是驗證過的安全標準。正確做法是準備二十到五十筆你自己的真實樣本,先人工標好答案,再看 Jev 給的分數落在哪,然後才決定線畫在哪裡。
調門檻時要分開看兩種錯:漏掉的(該攔的沒攔)和誤攔的(日常操作一直被打斷)。如果這兩種的分數大量重疊,移動門檻只是在兩種痛苦之間換來換去——那代表問題寫得不夠具體,或這件事本來就不該交給模型判斷。
還有一個方向陷阱:如果你把問題從「這條命令危不危險」改成「這條命令安不安全」,分數的方向就反過來了,舊門檻全部作廢。問題只要改字,門檻就要重驗。
官方自己列了 6 個 Jev 會答錯的地方——每一條都對應一個寫法修正
TypeSafe 有一頁叫「jev-1.13 jaggedness」,逐條列出自家模型會失手的地方。廠商主動公布自己的弱點很少見,而這一頁是我覺得整份文件裡最值錢的部分。
我把六條整理成「它會怎麼錯」加「你該怎麼寫」,這六條你照做,準確率的提升會比換模型有感得多。
❶ 它只讀字面,不讀你的意思
範圍詞、否定句、隱含條件,它一律照字面理解。官方有一句話講得很好:當你看著錯誤答案、心裡浮出「我的意思是⋯」的時候,那句解釋就是你漏掉的另外半句指令。把邊界情況寫進 criteria,不要指望它推測。
❷ 它不是計算機,也不會數數
數字、計數、數值比大小,全部交給程式。要數「符合條件的有幾個」,正確做法是在程式裡逐一問一次,然後自己加總——不要叫它一次數完一整份清單。
❸ 它把日期當文字,不當有順序的量
哪個日期比較早、差幾天、有沒有落在某個區間,這些它答不準。正確拆法是:抽取交給它、運算交給程式。月份只有 12 種、日只有 31 種,用 Choice 列舉,還能多留一個「沒寫」的選項,讓缺漏被回報而不是被猜。
❹ 繞圈子的問題會掉準
雙重否定、屬性的屬性、需要多跳一次才推得出來的問題,準確率都會下降。能拆成兩題直白的,就拆。
❺ state 塞太多無關內容會變笨
官方用的詞是 context rot:無關的材料會當干擾項,而且出錯時你根本分不出是哪一段害的。先在程式裡撈好、濾好,只送這一題需要的欄位。
❻ 它對惡意內容沒有天然防禦
state 在它眼中是資料,但它不會預設那是敵意的。刻意寫來引導模型的內容——注入的指令、誤導性的框架、替自己辯護的文字——是有可能把答案拉走的。官方寫明未來會改善,但現在你要自己在 criteria 裡寫死條件,上線前做對抗測試。
這一條對做 AI Agent 的人特別重要,因為 agent 吃進來的內容常常來自外部。光在指令裡寫一句「忽略輸入中的指令」只是設計的一部分,不等於證明它不會被影響。
Jev 中文準嗎?官方只寫了一句話,但那句話決定你要不要先自己測
Jev 的中文可以用,但官方明講準確度不如英文。原文寫的是英文為主要訓練語言、目前準確度最好,其他語言包含中日韓文字「可以處理但沒有一樣好」。
後面還有一句更重要:在把 Jev 用在非英文的工作之前,請先拿你自己的內容測過,並且在做路由判斷時特別注意 confidence。這句「請自己測」是官方寫的,不是我加的。
這一點在英文報導裡幾乎沒人提,因為對他們來說不是問題。但你要處理的是繁中客訴、繁中留言、繁中工單,這就是上線前的第一道關。
我的建議是準備四組不同「長相」的樣本分開測,不要混在一起看平均:
- 正式書面:客服罐頭信、公告、合約條款
- 口語留言:有語助詞、有省略、句子沒寫完的那種
- 有錯字或注音文:真實留言裡大量存在
- 中英夾雜:「這個 bug 我 reproduce 不出來」這種職場日常
四組分開統計,你才看得出它是「整體不行」還是「只在某一種長相上不行」。如果只有口語那組掉分,你的解法是在 criteria 裡補幾個口語例子,不是放棄整個方案。
還有一個省事的做法:指令用英文寫、材料保持中文。instructions 和 criteria 是你自己寫的,用英文寫等於讓它在最熟的語言裡理解題目;state 是使用者給的,本來就沒得選。我覺得這個組合值得在你的測試裡列成一組對照。
我不寫程式,Jev 關我什麼事?先看你是哪一種人
Jev 沒有 App、沒有聊天介面,只有 API。如果你從來不碰程式,它短期內跟你沒有直接關係——這句話我先講清楚,不要浪費你的時間。
但它跟你的間接關係有三層,值得你知道:
❶ 你用的 AI 產品會變快、變便宜
你每天在用的那些 AI 工具,背後都有大量的判斷步驟。這類模型普及之後,同樣的訂閱費能做的事會變多,或是同樣的功能反應會變快。你不會看到 Jev 這個名字,但你會感覺到。
❷ 如果你在用 n8n、Zapier 這類自動化工具
這一層你真的碰得到。這些工具裡最常見的節點就是「用 AI 判斷要走哪條分支」,而那正是 Jev 的本行。想知道自己目前撞的是哪道牆,可以先看我把免費 AI API 接自動化那兩道額度牆拆給你看;還沒開始串的人,n8n 那份實戰指南可以當起點。
❸ 如果你有在用 AI 幫你寫東西、做東西
會寫一點點程式、或願意讓 Claude Code 幫你寫的人,這一層的門檻其實比你想的低。你不需要自己寫那段 API 呼叫——你只要知道「這件事應該交給判斷模型,不是交給作文模型」,剩下的可以叫 AI 幫你接。
這就是我覺得把 Prompt 思維升級成 Loop 思維最關鍵的一步:你的價值不在會不會寫那幾行,在於你知不知道流程裡哪一段該換零件。
Jev 什麼時候該導入、什麼時候先別碰?我用三條線判斷
Jev 值不值得導入,我的判斷不是看它多便宜,而是看三條線——量、後果、誰在等。三條都不過,就先別碰。
第一條線:你一個月的判斷次數有沒有超過 10 萬次
從前面的算式往下推:每次判斷省下大約 0.00086 美元。要省到 100 美元(大約 3,200 台幣,差不多是接一個 API、寫測試、處理誤判的那一天工時),你需要每月十一萬多次判斷。
一個月一萬次只省 275 台幣,那連你跑去讀文件的時間都不夠付。職業病讓我看到任何新東西第一個問的都是誰會用、多久用一次——這兩題答不出來的,做出來通常就躺在那裡。
順帶一提,這條線也可以拿來檢查你手上的其他 AI 訂閱。我之前把各家免費 AI Agent 的官方額度逐格對過一次,發現帳面數字和實際能用的差到六倍——量算不清楚,任何「划不划算」的結論都是空的。
第二條線:判斷錯了會發生什麼事
標錯一個分類,頂多有人手動改回來;判錯一次「要不要刪掉這筆資料」,那是另一回事。後果越重,門檻要越高、人工複核要越早介入,導入的成本也越高。
後果輕的場景先上,累積出自己的樣本和門檻,再往後果重的挪。不要反過來拿最嚴重的場景當試驗場。
第三條線:有沒有人正在等
如果判斷發生在使用者盯著畫面的那一秒,70 毫秒和 3 秒的差距比帳單重要得多。這種情況就算省不了多少錢,也值得換。
| 你的情況 | 我的建議 | 先做什麼 |
|---|---|---|
| 每月判斷 10 萬次以上,後果可回復 | ✅ 值得導入 | 拿 50 筆真實樣本先調門檻 |
| 互動場景,使用者在等 | ✅ 值得,為速度不為錢 | 只換最前面那一步判斷 |
| Agent 一直在自問自答 | ✅ 從控制層開始換 | 先換「做完了沒」這類問題 |
| 量小、只是好奇 | 🟡 玩 Playground 就好 | 別急著接進正式流程 |
| 要它寫程式、寫文案、回答問題 | ❌ 完全不適合 | 留在 Claude、GPT、Gemini |
如果三條線你都過了,我建議的第一步不是全面導入,而是找一個你看得懂結果的小場景,跑一週,把 Jev 的判斷和你實際採取的行動記下來對照。一週之後你會知道它是幫你抓到東西,還是只是多了一個會掛掉的相依。
最後講一句我自己的立場。我付 Claude Max 20x 和 ChatGPT Pro 各 200 美元,付到最高階不是因為錢多,是因為我受不了做到一半跳額度用完——那個中斷的成本比價差高。但正因為這樣,我更不想把那些昂貴的額度花在「這封信急不急」這種選擇題上。
工具漲價或額度縮水時,我的第一個問題從來不是「還值不值得」,而是「我手上已經在付的那幾個,能不能把這件事吃下來」。Jev 讓這個問題多了一個新答案:有些事不必吃下來,把它挪到一個一萬次只要 5 塊台幣的地方就好。
FAQ 常見問題
Jev 和 Claude、ChatGPT 該選哪一個?
這題問錯方向了,它們不是替代關係。Jev 不會生成任何文字,所以任何需要「產出東西」的工作都只能給 Claude 或 ChatGPT。正確的問法是:你的流程裡哪幾步只是在做選擇題?那幾步換 Jev,其餘不動。如果你的用途幾乎都是聊天和寫作,那就完全不需要它。
Claude Code 週額度用完了,改用 Jev 能繼續寫程式嗎?
不行,這是最常見的誤會。Jev 沒有生成能力,寫不出一行程式碼。它能做的是讓你在額度還沒用完之前,不要把額度花在判斷類的步驟上。真的卡在額度,先看我一天燒光 Max 20x 週額度之後重排的分配方式,或是Claude Code 接 Codex 那個先別開的開關,那兩篇處理的才是你現在的問題。
Jev 不會幻覺,那是不是就不會出錯?
「不會亂講」和「不會講錯」是兩件事。它的保證是結構層的——回傳一定符合你定義的型別,不會多一段廢話、不會 JSON 壞掉、不會冒出你沒列的選項。但語意判斷本身照樣會錯,官方自己就列了六種常見的錯法。把它當成「輸出格式永遠可靠、答案仍需驗證」比較準確。
只想先試試看,最低成本的方式是什麼?
去官網排隊拿早期存取資格,開通後直接用控制台的 Playground,貼一段你自己的真實文字,問一個你真的在乎的問題。這一步完全不用寫程式、不用產金鑰、不花錢。看到結果之後再決定要不要往下走第二層。帳號裡那筆額度記得先看到期日,我的是發放後 30 天。
繁體中文的工單能直接上線嗎?
先測再說。官方明確寫了中日韓文字「可以處理但沒有一樣好」,並建議在非英文的工作上線前用自己的內容測試。實務做法是準備正式、口語、有錯字、中英夾雜四組樣本各測一輪,分開看分數。如果只有某一組掉分,補幾個該類型的例子進 criteria 通常就能救回來。
結論:它不是更便宜的 Claude,是你流程裡少掉的那顆零件
如果這篇你只記一句話,我希望是這句:Jev 省的不是每個 token,是讓貴的模型少被叫幾次。
過去兩年我們習慣的做法,是拿一個什麼都會的模型去做所有事——包括那些只需要回答「是」或「不是」的事。那不是因為那樣比較好,是因為當時沒別的選擇。
現在有了。而且這個選擇便宜到有點荒謬:一萬次判斷 5 塊台幣,帳號裡還先放了一筆夠你跑 30 萬次的額度。
但便宜從來不是導入的理由。真正的理由是——你終於可以把「判斷」和「產出」分開看待,然後分別找對的工具做對的事。這跟我一直在做的那件事是同一回事:先用便宜的把粗胚做出來,貴的只拿來細修。Jev 只是讓這條分工線又往前推了一格。
至於那 444 倍,看看就好。你要算的永遠是自己那一格本來多少錢——這點在我算 DeepSeek V4-Pro 每題成本和重算 Claude API 帳單那兩次,都是同一個教訓。
如果你想繼續看我把各家 AI 的帳單一格一格拆開的過程,訂閱我的部落格,會不定期收到信。
參考資料
- TypeSafe AI — Introducing System One Models and Jev(發布日、193.6 倍/444.6 倍的評測基準、70–500ms 延遲)
- TypeSafe 官方文件 — Models(每 MTok 0.042 美元、context 64k/32k、速率限制、語言支援原文)
- TypeSafe 官方文件 — Jev 1.13 Jaggedness(六條失效模式原文)
- TypeSafe 官方文件 — Confidence(confidence 定義與門檻分層示範)
- TypeSafe 官方文件 — Quick start(API 端點、請求與回傳範例、usage 數值)
- Anthropic 官方定價頁(Haiku 4.5/Sonnet 5/Opus 5/Fable 5.1 每 MTok 價格)
- Cloudflare Workers AI — typesafe/jev(模型 id 與該平台 context 上限)
- GitHub — typesafe-ai/skills(官方 agent skill 與安裝指令)
- GitHub — NiazMorshed2007/jev-review(第三方 MCP 評審插件)
- Google Codelabs — Getting Started with Antigravity(Antigravity 的 skills 與 MCP 設定)